Table of Contents
Open Table of Contents
Bibliometría
Base de datos
Partimos de la base de datos, en formato .bib, que usted ya construyó. Aquí lo trabajamos en una página anterior.
Bibliometría Con Rstudio y Bibliometrix
El paso de instalación sólo se hace una vez por PC.
Instalación de R y RStudio
-
Se descarga el instalador de R desde la página https://cran.r-project.org/bin/windows/base/
-
Se ejecuta el instalador
-
Se descarga el instalador de Rstudio desde la página: https://docs.posit.co/ide/user/#rstudio-ide-oss-downloads
-
Se ejecuta el instalador.
Lo explican en videos en youtube, por ejemplo: https://www.youtube.com/watch?v=hbgzW3Cvda4
Instalación de Bibliometrix
-
Se abre Rstudio
-
En la Consola se escribe:
install.packages("bibliometrix"). Esto instala el paquete.
Lo explican en la página https://youtu.be/CiHVln8rrPY?si=Uwnh8xjX5c4Cpt0X&t=203
Correr Bibliometrix.
Se deben ejecutar dos comandos, library(biblioshiny) y biblioshiny(). Esto se puede hacer de dos formas.
- Se escriben las instrucciones en la sección de scripts y luego se vuelve a poner el cursor en la primera instrucción y se presiona dos veces el comando “Run”.
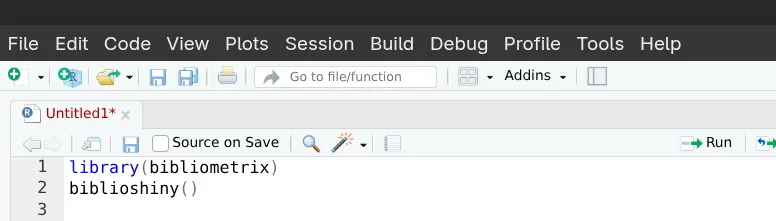
- O se escriben los dos comandos en la consola.
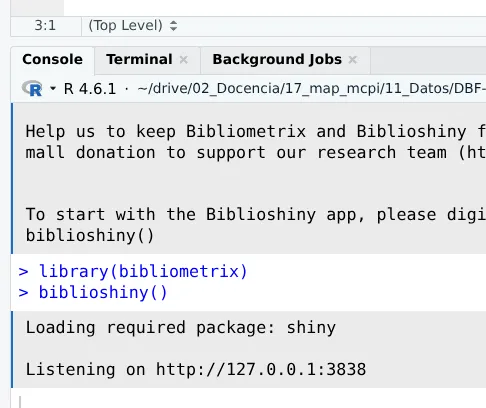
En cualquiera de las dos formas el resultado es que el sistema lanza una página web, que corre localmente, que accede al biblioshiny.
Cargar los datos
Se hace click en
Data ➡️ Import or Load
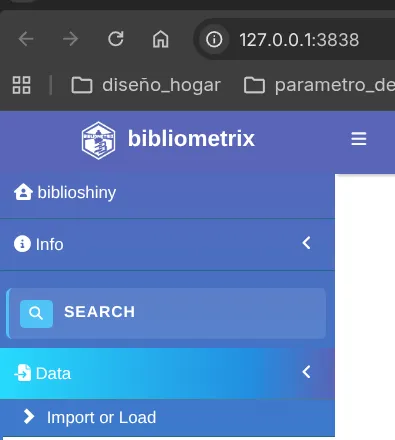
Esto lanza un panel a la derecha donde se debe elegir
import raw files ➡️ Scopus ➡️ Surname and initials ➡️ Browse
Y a continuación se escoje el archivo .bib que habíammos generado en Scopus. Se hace click en Start.
El primer reporte que genera el sistema describe el nivel de completitud de los registros de la base.
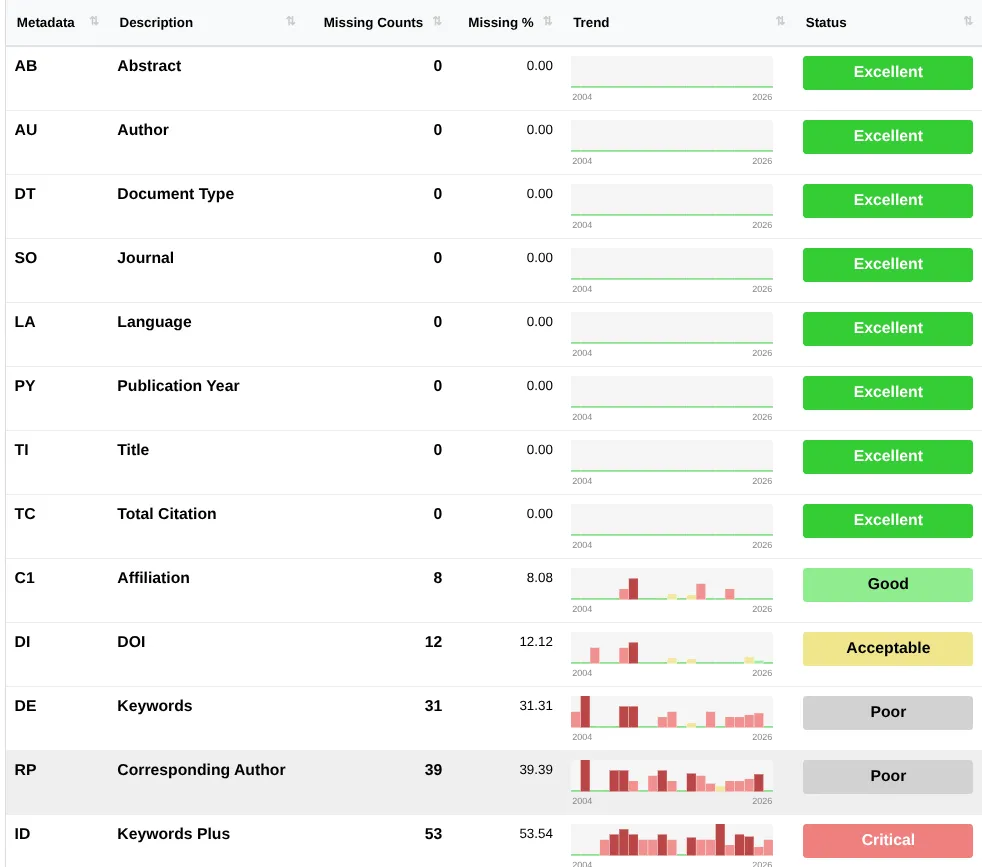
Se cierra en el botón
Análisis de Bibliometrix
El panel izquierdo presenta diferentes opciones. Para correr el análisis se usa el botón azul de “play” ▶️.
Overview
Descripción general de la base de archivos.
-
Main Information: Muestra estadísticas descriptivas de la base
-
Annual Scientific Production: Es una gráfica del número de artículos como función del tiempo. Es muy común que muestre un crecimiento acelerado.
Sources
Información sobre las revistas de donde salen las publicaciones. Es útil para determinar cuáles son las más relevantes.
Authors
Información sobre los autores de los artículos de investigación.
-
Most Relevant Authors: Muestra los autres más proíficos de la base de datos, con las cuentas de cuántas publicaciones aparecen para cada uno.
-
Corresponding Author’s Countries: Indica la producción de artículos, con respecto a los países en los que está la filiación de los autores. Marca diferente las colaboraciones de varios países con las de un sólo país. Usualmente los sospechosos de siempre, China, USA, UK, aparecen como los primeros países, si se trabaja en inglés.
Documents
Inforamción sobre los artículos mismos.
-
Most Globally cited documents: Organiza los artículos por orden descendiente de citaciones. Esta puede ser una característica útil para determinar cuál de los documentos es más influyente en la literatura, y por lo tanto puede ser importante leerlo.
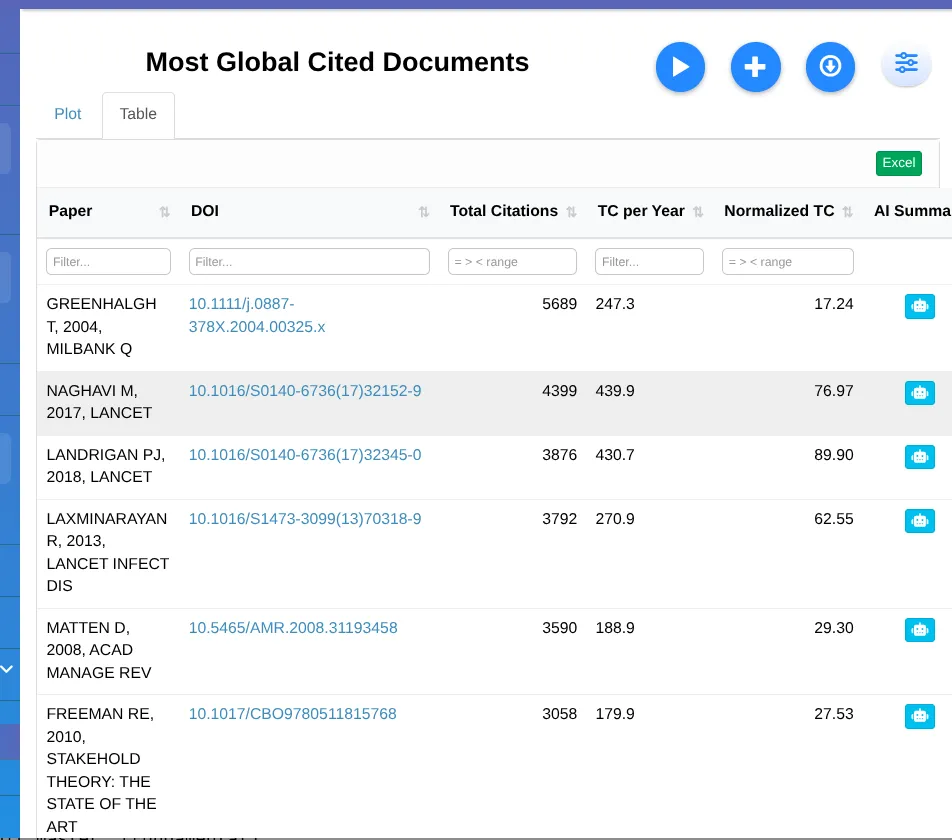
Recordemos que como ejemplo estamos trabajando una búsqueda enfocada en la siguiente cadena “(public policy OR public administration) AND (climate change) AND ((latin america OR caribbean) AND NOT brasil)”. En éste ejemplo particular, encontramos que los artículos más citados corresponden a GREENHALGH T, 2004; NAGHAVI M, 2017; LANDRIGAN PJ, 2018; LAXMINARAYAN R, 2013; y MATTEN D, 2008. Los títulos de dichos artículos son los siguientes:
- GREENHALGH T, 2004, Diffusion of Innovations in Service Organizations: Systematic Review and Recommendations
- NAGHAVI M, 2017, Global, regional, and national age-sex specific mortality for 264 causes of death, 1980–2016: a systematic analysis for the Global Burden of Disease Study 2016
- LANDRIGAN PJ, 2018, The Lancet Commission on pollution and health
- LAXMINARAYAN R, 2013, Antibiotic resistance—the need for global solutions
- MATTEN D, 2008, “Implicit” and “Explicit” CSR: A Conceptual Framework for a Comparative Understanding of Corporate Social Responsibility
Una lectura del título sugiere que, aunque hay relación entre los temas, el enfoque principal de éstos artículos no es el idéntico a la pregunta de investigación. Luego esto nos puede dar luces para identificar si se requiere refinar la búsqueda, o si se incluyen los criterios de revisión.
-
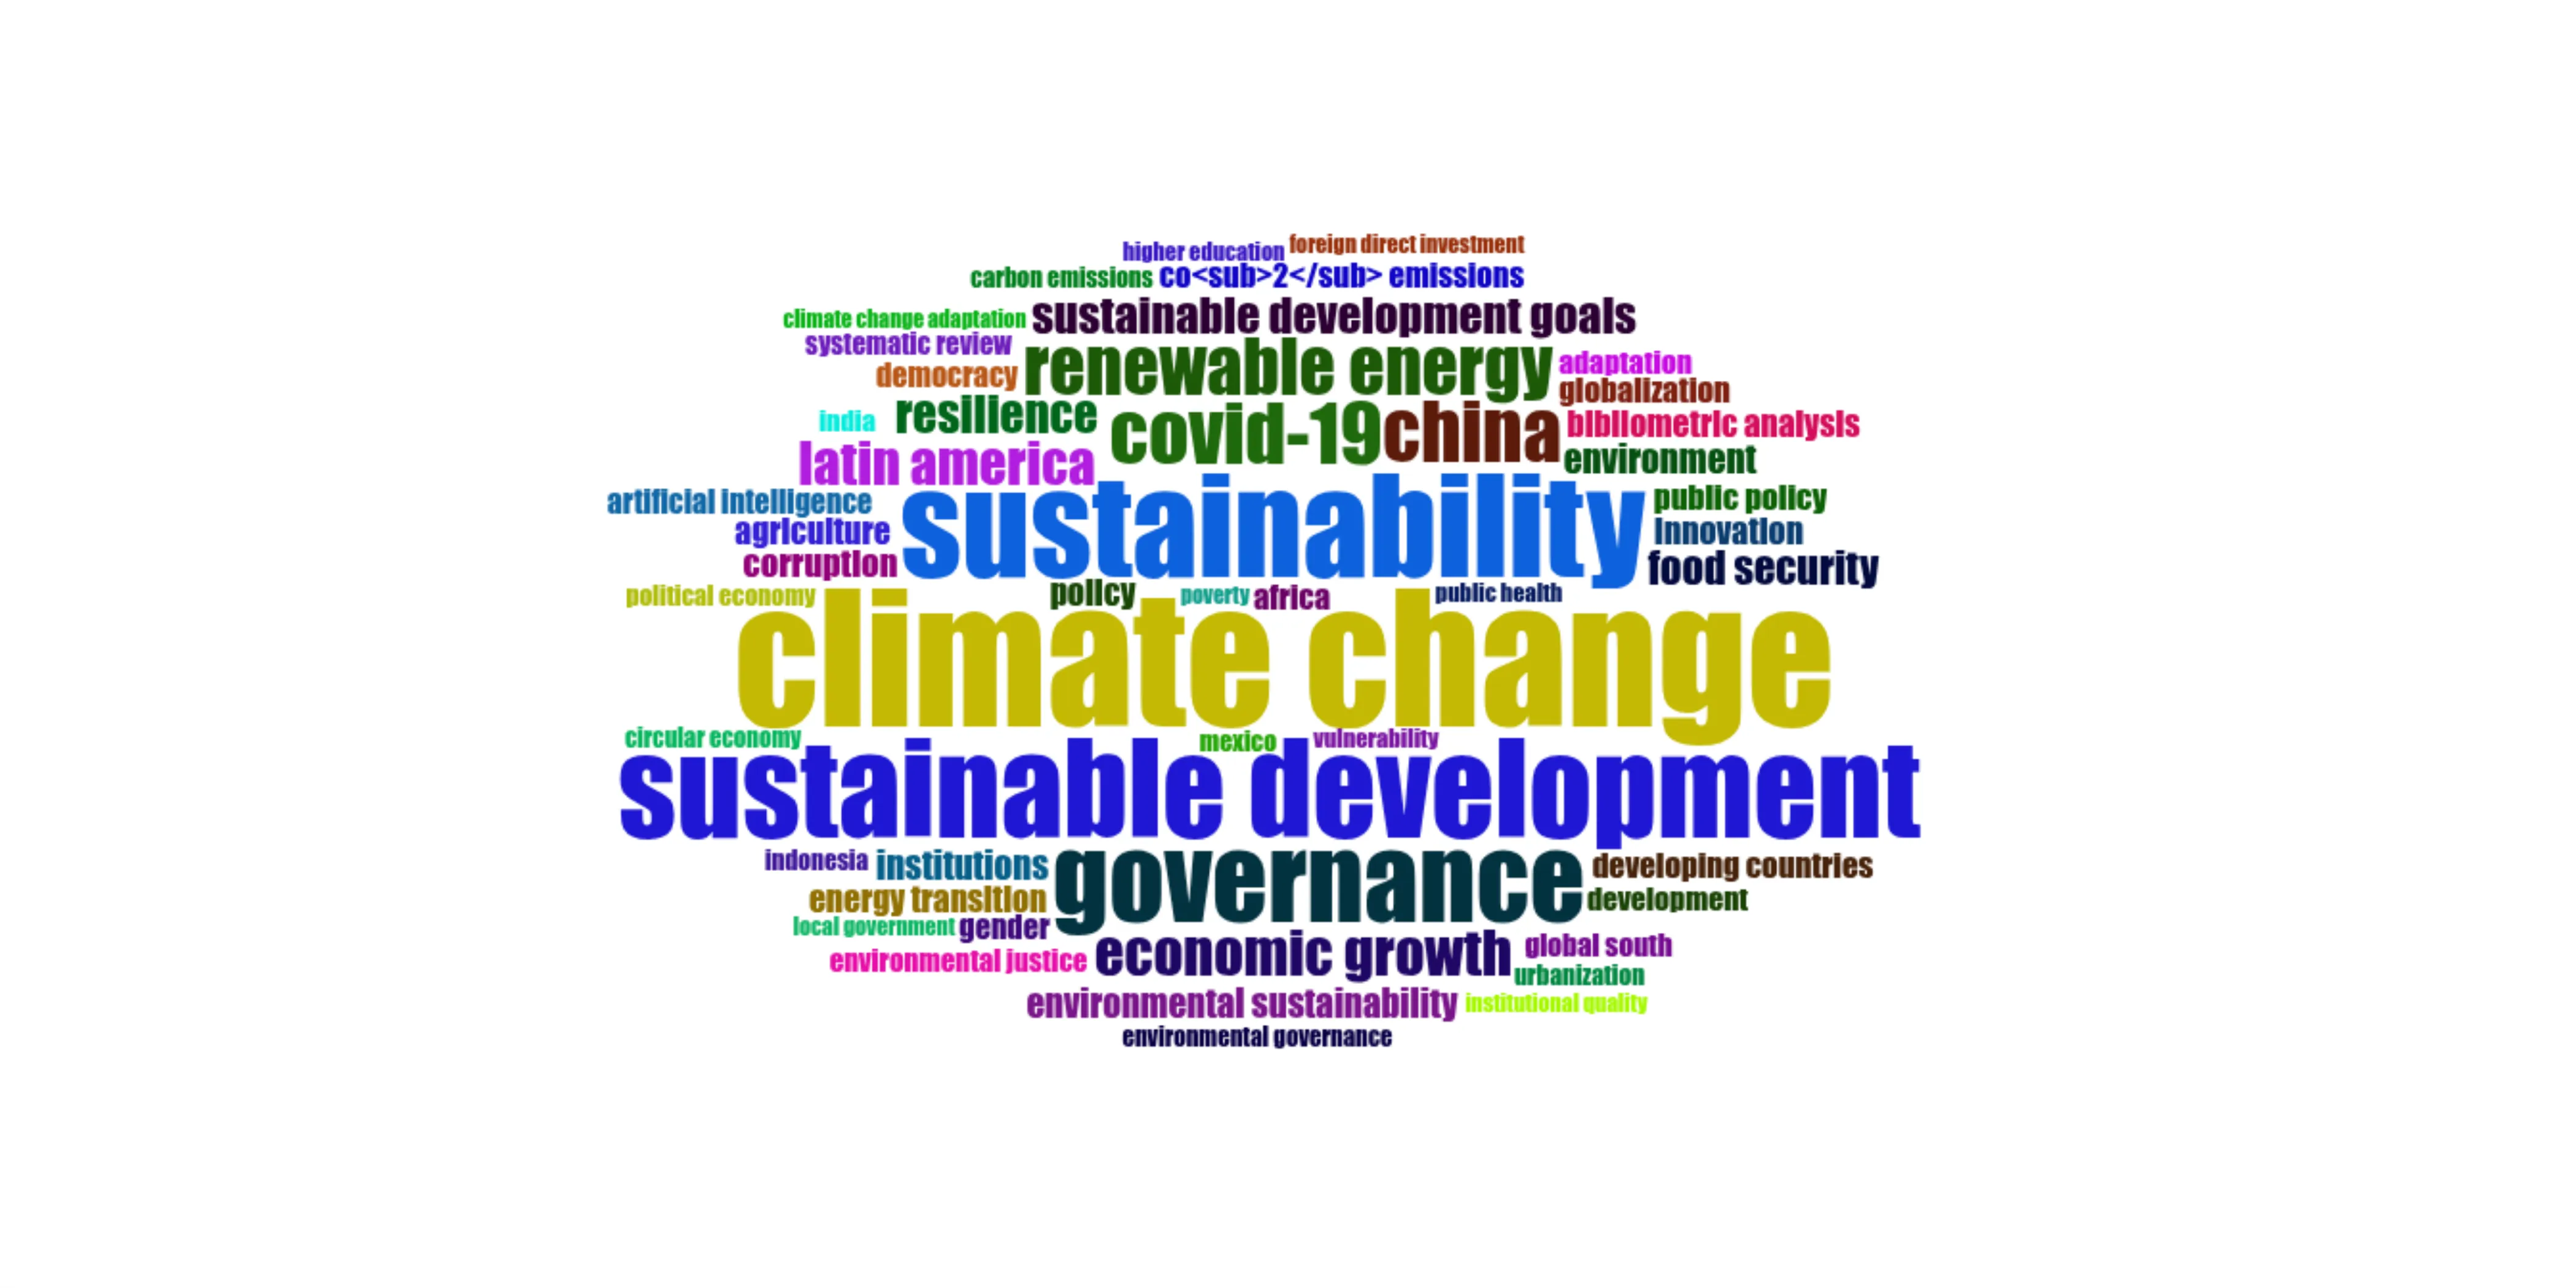
Most Frequent Words / WordCloud: proveen una visión general de las palabras claves de la base de datos. Aquí es importante ir al panel de configuración y elegir “author keywords”, para incluir únicamente las generadas por los autores de cada documento (si no se hace así, puede generar fallas).
Para el ejemplo que venimos trabajando se obtienen las siguientes:
| palabra clave | conteo |
|---|---|
| climate change | 375 |
| sustainability | 285 |
| sustainable development | 271 |
| governance | 237 |
| covid-19 | 172 |
| china | 168 |
| renewable energy | 155 |
| economic growth | 127 |
| latin america | 118 |
| resilience | 105 |
-
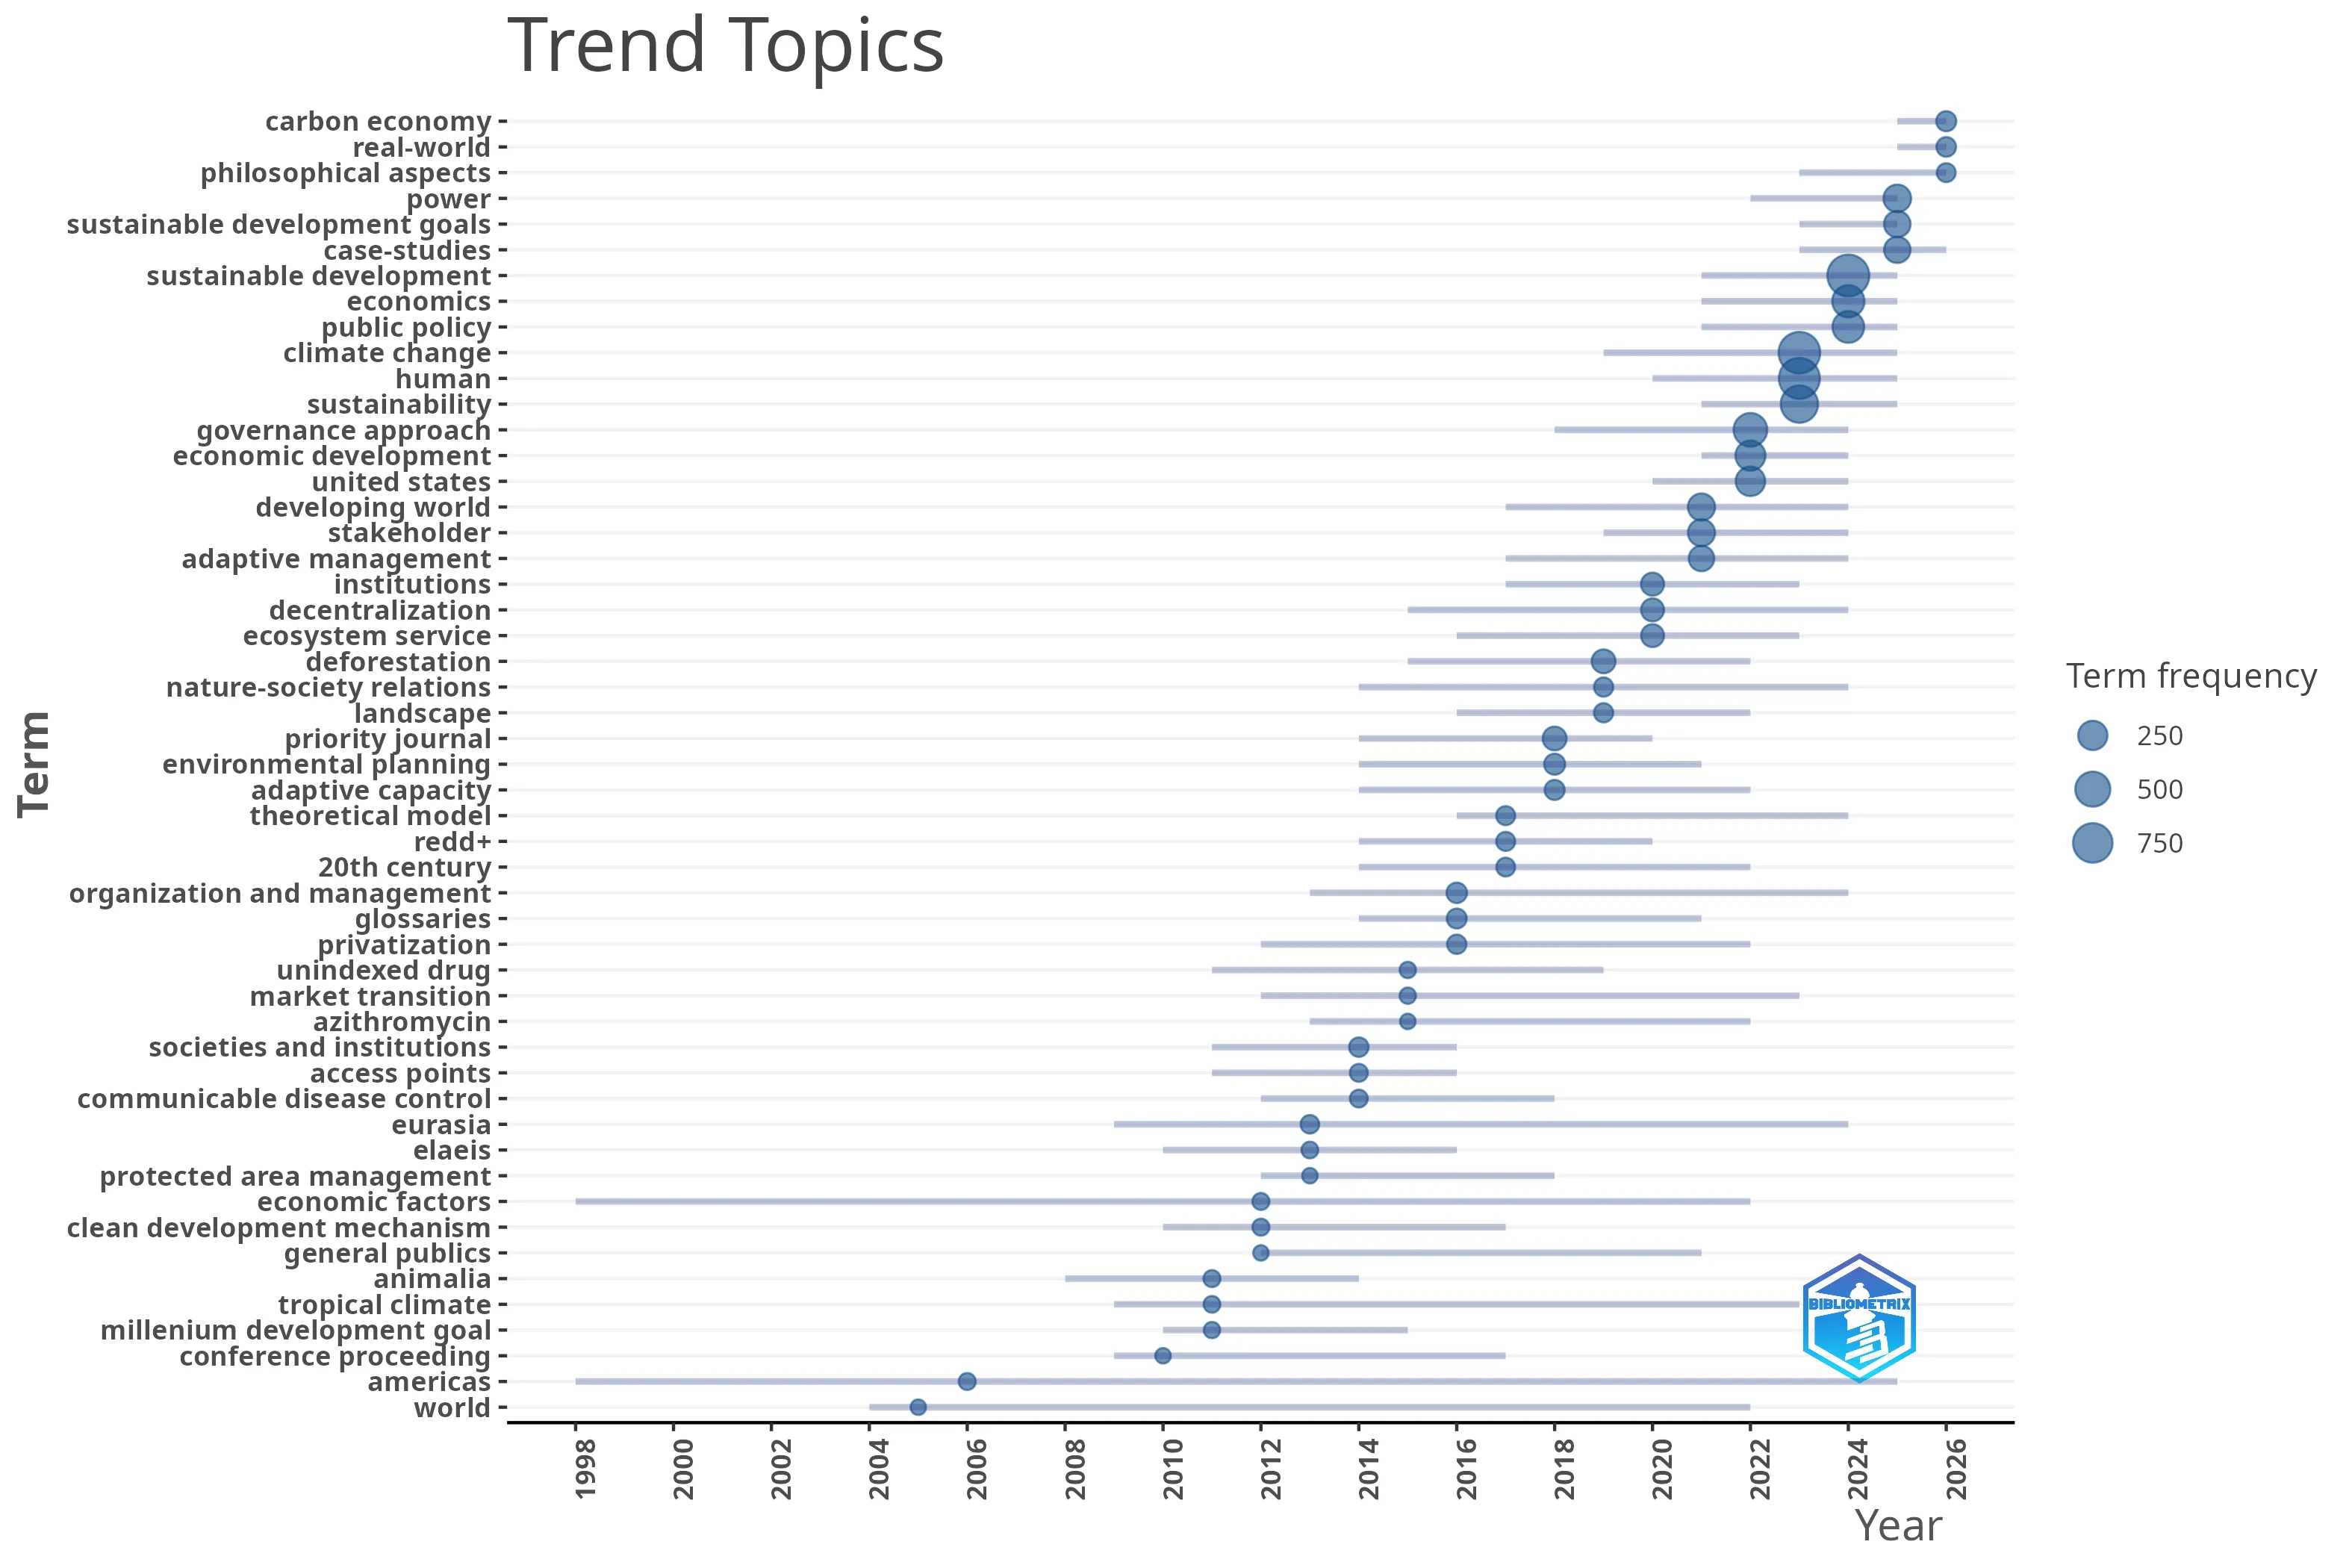
Trens Topics: identifica los temas (términos) más usados en la base de artículos como función del tiempo en el que han sido más relevantes. Esto permite ver cómo evoluciona la conversación alrededor del área de investigación, o cuáles son los términos que han impactado y se continúan usando durante toda la franja temporal bajo estudio.
Conceptual Structure
Provee un análisis de redes, en el que se relacionan en clusters los diferentes términos o temas.
-
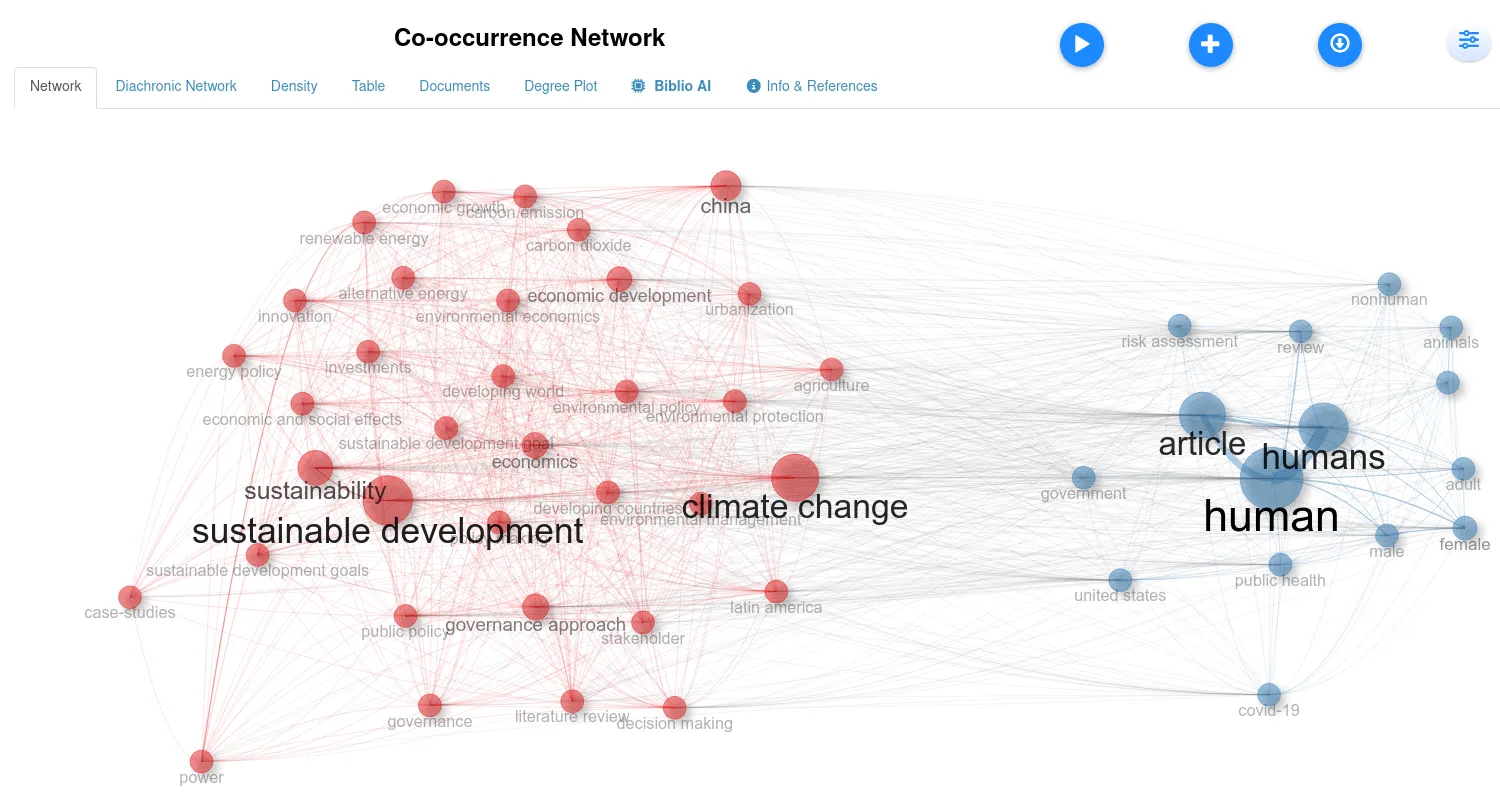
Red de Co-ocurrencia: aquí los nodos representan los términos y los enlaces conectan términos que aparecen en el mismo documento. El nivel de correlación está relacionado con la frecuencia.
Por ejemplo, para la estructura de la que estamos trabajando tenemos dos grupos grandes. Por un lado, en rojo, están los temas de de desarrollo sostenible, cambio climático, sostenibilidad y desarrollo económico. Por otro lado hay un cluster relacionado con el término “humano”, “artículo” y “Salud pública”
-
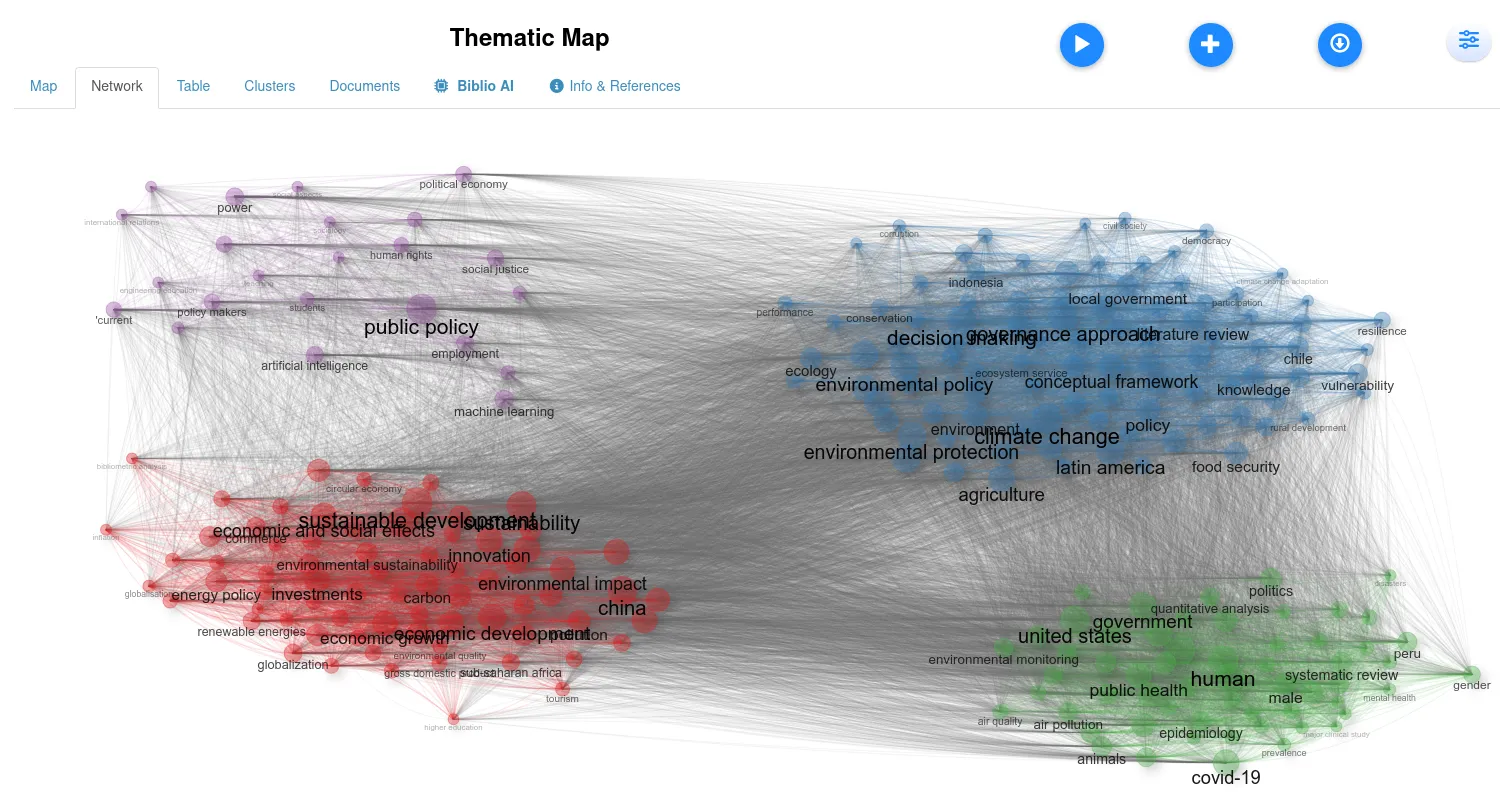
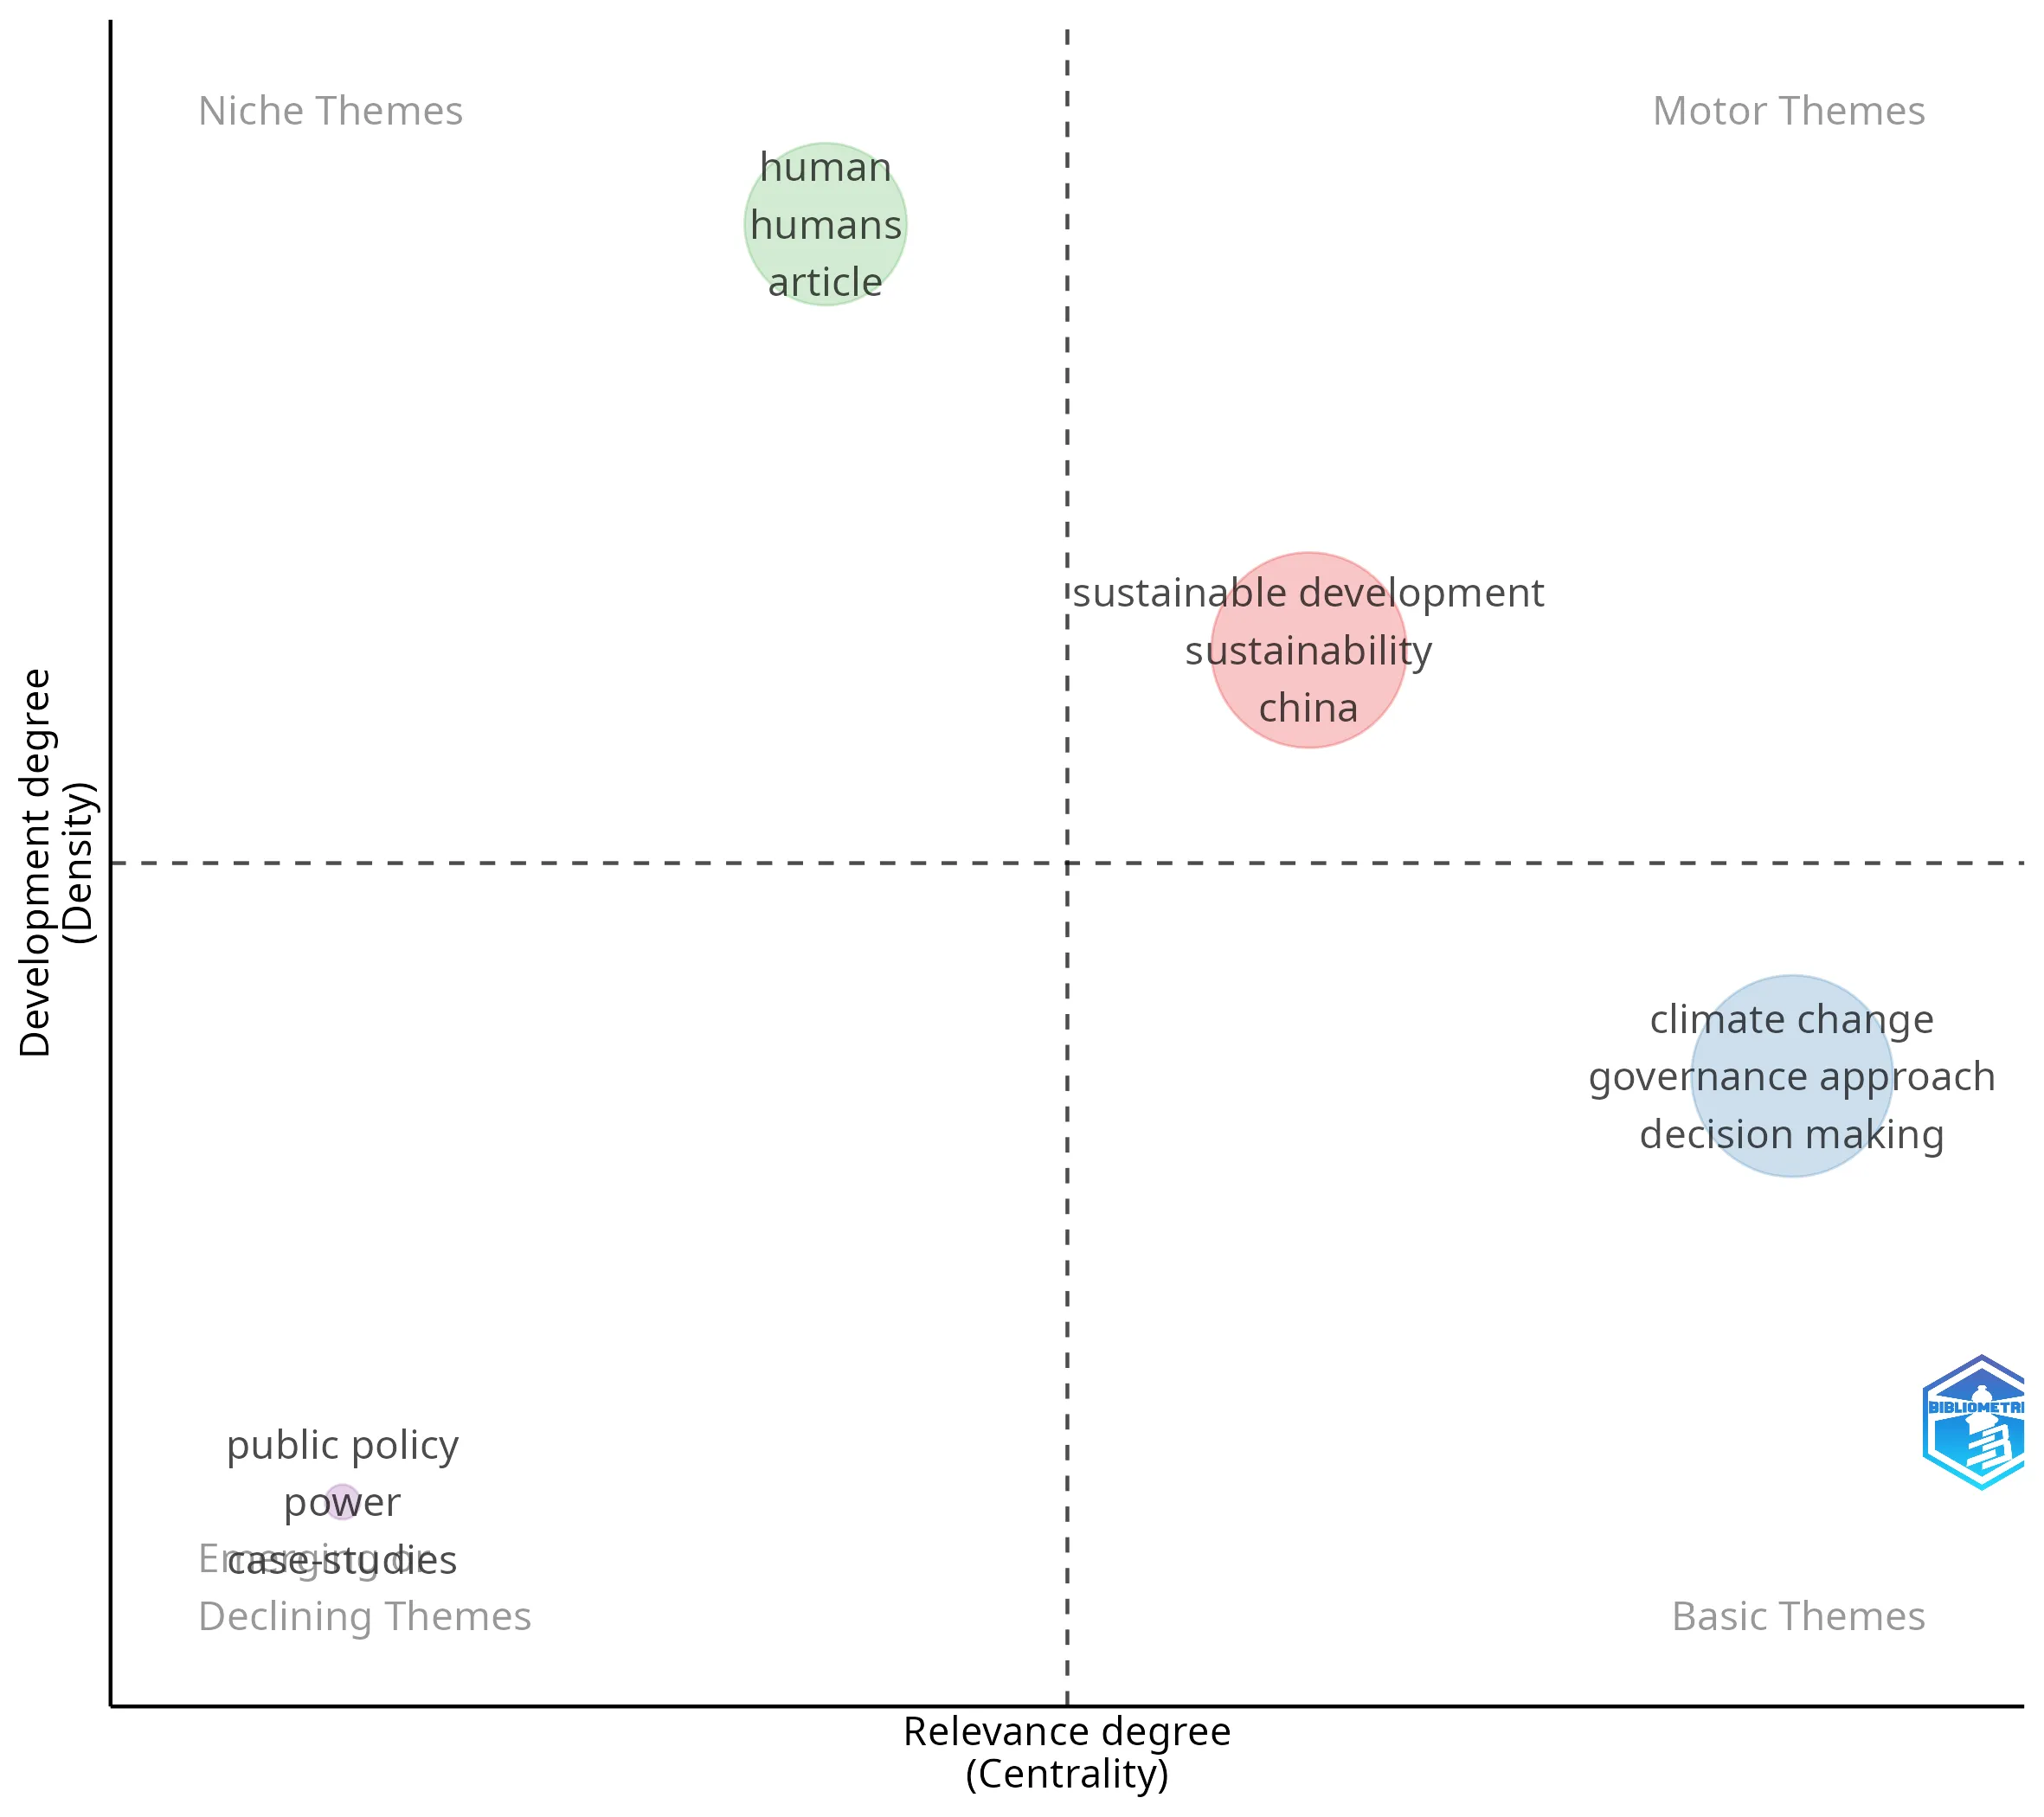
Mapa temático: es una medida de la madurez del área de estudio. Representa la centralidad, o importancia dentro del campo; con la densidad, coherencia interna del tema.
En el ejemplo del que estamos trabajando se caracterizan cuatro grupos. En la esquina de baja centralidad y baja densidad está uno que relaciona “public policy”, “power” y “case studies”; lo que puede indicar que esta es un área en la que hace falta desarrollo. Un tema con alta centralidad pero poca densidad es el de “climate change”.
Social Structure
Finalmente se puede llevar a cabo un análisis descriptivo sobre las colaboraciones científicas representadas en la base. En el ejemplo que hemos trabajado, la red es la siguiente:
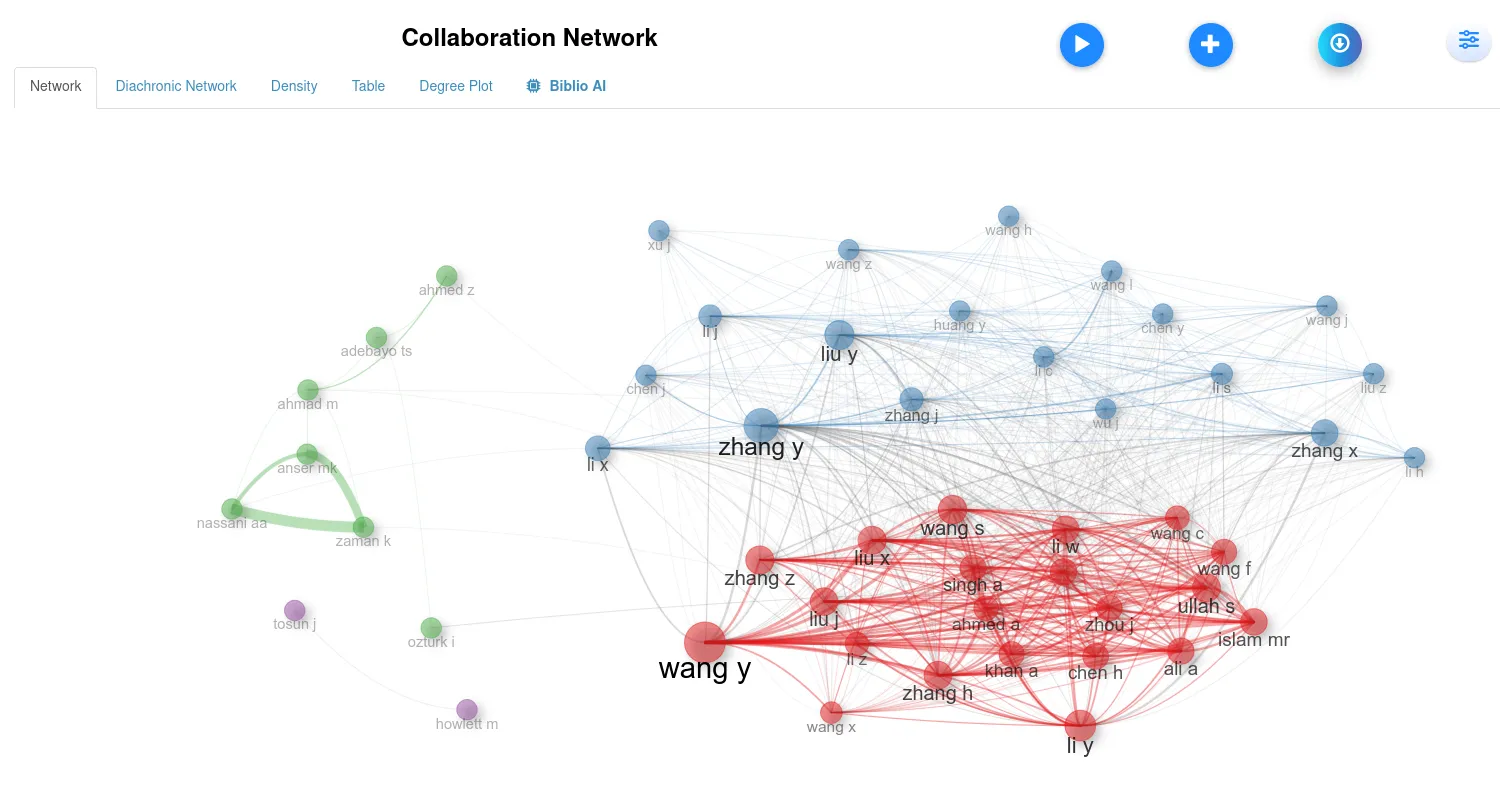
Se identifican cuatro redes. Una alrededor de Wang, Y,en rojo. La pestaña de autores permite identificar que se trata de Ying Wang, y nos dá acceso a su ORCID.
Conclusión
El ejemplo que hemos mostrado permite identificar tendencias relativas al desarrollo de la temática. En este caso esas tendencias sugieren la necesidad de acotar más el área de estudio, toda vez que ni en los artículos más citados, ni enlos autores encontramos personas de latinoamérica. Es posible que su participación quede oculta dentro de un grán volumen de producción de otros temas, como también puede ser que sea poca.
La siguiente etapa consiste en una revisión cualitativa, en la que se definen una serie de categorías de análisis y se construyen los criterios de inclusión y exclusión.
Más software de Bibliometría
Desde la Universidad del Cauca, Juan Pablo Ruiz Rosero genera ScientoPy. Al parecer requiere instalación local (no correría en colab de google).
https://github.com/jpruiz84/ScientoPy/blob/master/Manual/ScientoPy_user_manual.pdf
Gestores bibliográficos: Zotero
Son programas que facilitan el manejo de la bibliografía, al centralizar en un repositorio toda la información bibliográfica de cada uno de los registros que hacen parte de la revisión bibliográfica. Su uso simplifica la citación dentro de los documentos de investigación; ya sea para un trabajo de grado, tesis o artículo de investigación.
La documentación de Zotero está disponible en su página web, aquí hablaremos de algunos aspectos puntuales.
Instalación de Zotero
Usualmente se instalan dos programas, Zotero y Zotero Connector. El primero es el programa que corre en su PC, y que lleva el registro de las bases de datos de artículos, permitiendo su interacción con el software de escritura de documentos. El segundo es un plug-in para su navegador, que permite añadir a la base de datos entradas desde la red.
https://www.zotero.org/download/
Uso con el procesador de texto
Permite incluir la bibliografía en Google Docs, https://www.zotero.org/download/; LibreOffice, https://www.zotero.org/support/libreoffice_writer_plugin_usage; y word, https://www.zotero.org/support/word_processor_plugin_usage.
Importar base
Es posible ingresar la base que descargamos de Scopus. La ruta es:
File ➡️ Import ➡️ A file
Allí se elige el Archivo.
En las opciones recomiendo hacer click en el cajón 🔲 en “Place imported collection items into new collection”, para que genere una nueva colección. Y la opción “Link to files in original location”, para que en caso de que tengamos el artículo lo trabaje localmente. De otra forma se puede saturar el espacio permitido para cuentas gratis.
🤓
Existen diferentes formatos de bases de datos. Cuando elegimos .bib estamos usando el formato compatible con . Este es un sistema de preparación de documentos utilizado principalmente en matemáticas, física, ingeniería y ciencia de datos. Para nosotros su uso es transparente, no tenemos que interactuar con los archivos fuente.