Table of Contents
Open Table of Contents
Distribuciones continuas de probabilidad
Anteriormente habíamos hablado de probabilidad de variables discretas. En ese caso la variable aleatorio tiene un número entero de opciones. Por ejemplo el número de personas que acceden a un servicio al día es una variable aleatoria discreta.
Es posible que la variable aleatoria no sea discreta (contable) si no continua. Por ejemplo el peso de las personas que están en un bus, o la estatura de una persona, o la cantidad de electricidad que consume un hogar, son todas variables continuas.
Aquí comparamos la probabilidad discreta y la continua:
| Probabilidad Discreta | Probabilidad Continua |
|---|---|
| Es un número entre 0 y 1 | Es un número entre 0 y 1 |
| Las opciones son contables | Las opciones son todos los números en un rango |
| Si un evento tiene una sóla opción, la probabilidad de es | Los eventos se definen como rangos, la probabilidad representa la posibilidad de que la variable tome un valor en el rango |
| (por ejemplo, en un dado de 6 caras la probabilidad de 3 es 1/6) | (en el ejemplo de la estatura hablaríamos de la probabilidad de que una persona al azar tenga una estatura entre 1.5 y 1.6 m) |
| Se define como | Se define con una función , densidad de probabilidad, como |
| Las opciones se llaman “espacio muestral”, y se representa por | Las opciones en teoría pueden ser todos los números reales, en la práctica son subconjuntos. |
| (por ejemplo, en un dado de seis caras tenemos ) | (por ejemplo, la estatura mínima de una persona son algunos centímetros y la máxima un par de metros, luego varía en el intervalo (0.3, 2) ) |
| La probabilidad de que la variable aleatoria tome alguna de las opciones es 1 | La probabilidad de que la variable aleatoria tome alguna de las opciones es 1 |
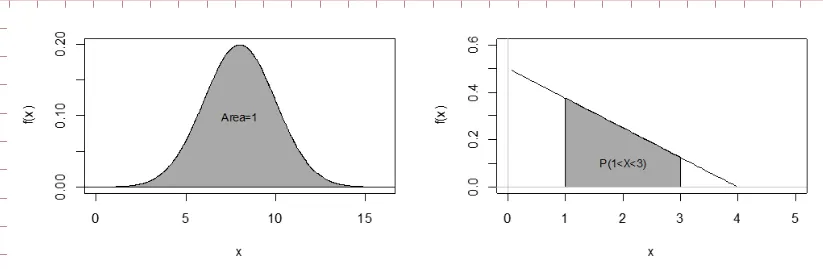
La segunda característica, integral igual a 1, se ve en la figura abajo izquierda. La segunda, probabilidad igual a área bajo la curva, en la figura de la derecha.
Distribución Gausiana
Una buena explicación de la distribución normal está en éste video del profesor Leandro González: https://youtu.be/-fD8KmtsI1M
Un grán número de variables del mundo real resultan tener una distribución normal. Por ejemplo:
- Características morfológicas: como talla, peso, long. total o parcial
- Características fisiológicas: como el efecto de dosis de un fármaco, o de cantidad de abono
- Características sociológicas: como el consumo de productos por grupos humanos
- Características psicológicas: como el CI, o grado de adaptación a un medio
- Características físicas: como la resistencia a rotura de piezas, vida útil de un producto, tiempo de traslado.
Características de la distribución normal
-
Está definida por dos parámetros, que son su promedio y su desviación estándar .
-
La variable aleatoria es continua. (en símbolos esto se escribe como: )
-
La función de distribución es simétrica.
-
Su mediana es igual a su moda.
-
Para valores muy grandes o muy negativos, tiende a cero (esto se dice como asintótica al eje x).
-
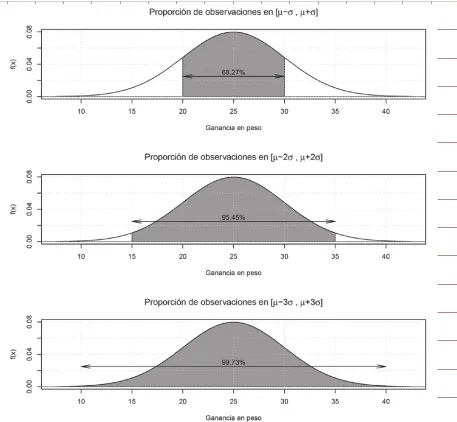
La probabilidad de que la variable aleatoria tome valores a una desviación estándar del centro es de aproximadamente el 68 % (esto se escribe matemáticamente como: )
-
La probabilidad de que la variable aleatoria tome valores a dos desviaciones estándar del centro es de aproximadamente el 95 % (esto se escribe matemáticamente como: )
-
La probabilidad de que la variable aleatoria tome valores a tres desviaciones estándar del centro es de aproximadamente el 99 % (esto se escribe matemáticamente como: )
-
🤓 Tiene la siguiente forma funcional:
Aquí es la desviación estándar, el promedio. Es una función exponencial. (Ayuda: aunque parece rara, usualmente se calcula con computadoras.)
-
🤓 Distribución Gaussiana Estandar: Para simplificar la forma funcional y poder realizar cálculos sin computadora, se ha estudiado la Gaussina que tiene , . Es:
Cálculo con el computador (en Python)
Se importa la librería statsde scipy:
import scipy.stats as st
Se usa la función st.norm.cdf, que con las opciones loc para el promedio y scale para la desviación estándar, da la probabilidad de que la variable sea menor a un valor dado.
Por ejemplo, supongamos que queremos encontrar la probabilidad de que una variable continua , que tiene promedio de y desviación estándar de tenga un valor menor a . Es decir, queremos . Se calcularía como:
st.norm.cdf(5.9,loc=10,scale=2)
Lo que da el valor: 0.020182215405704394, se puede aproximar a cuatro decimales en 0.0202.
Ejercicio,
Si el promedio es , la desviación estándar es , cuál es la probabilidad de que X tome un valor inferior a 14?
En este caso , queremos calcular P(X \leq 14). Entonces tenemos:
st.norm.cdf(14,loc=10,scale=2)
lo que da , que aproximamos a 0.9227.
Ejercicio,
Si el promedio es , la desviación estándar es , cuál es la probabilidad de que X tome un valor superior a 14?
Queremos
Pero como el software calcula la probabilidad a cola izquierda, lo hacemos así:
Luego calcularíamos:
1-st.norm.cdf(14,loc=10,scale=2)
Se obtiene 0.02275013194817921 o aproximando a cuatro decimales 0.0227.
🤓 Estandarización
Es un proceso para comparar distribuciones que tienen diferentes parámetros, pero que tienen la misma forma. Recordemos que la forma funcional de la gaussiana es ; fíjese que la variable aparece acompañada de y de la forma . La estandarización consiste en definir una nueva variable :
El valor determina la distancia, medida en desviaciones estándar, desde el promedio. Es positiva si está a la derecha del promedio y negativa si está a su izquierda.
Por la forma que tiene la distribución gaussiana, Z usualmente varía entre -3 hasta 3; es decir de 3 desviaciones estándar a la izquierda hasta 3 desviaciones estándar a la derecha.
🤓 Ejemplo, comparando resultados de dos exámenes
(fuente: Diez, D. M., Barr, C. D., & Cetinkaya-Rundel, M. (2012). OpenIntro statistics, página 134)
Supongamos que tenemos dos poblaciones a las que se les hacen exámenes diferentes, pero que tratan de medir lo mismo. Pueden ser exámenes saber 11 de dos años diferentes, que tratan de evaluar lo mismo pero resultan que en la práctica uno es más difícil que el otro. ¿cómo se pueden comparar los resultados personas que hicieron diferentes examenes?
-
Ana tiene un puntaje sin estandarizar de 370, y en su grupo el promedio fue de 350 con una desviación estándar de 20.
-
Juan tiene un puntaje sin estandarizar de 370, en su grupo el promedio fue de 360, con una desviación estándar de 5.
Cómo se puede comparar el puntaje de Ana con el de Juan?
La gráfica muestra distribución del grupo de Ana, en naranja; y la distribución del grupo de Juan, en azul.
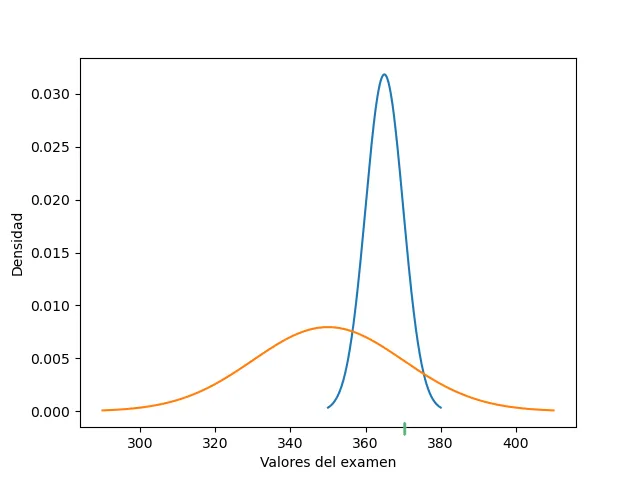
Aunque ambos tuvieron el mismo puntaje sin estandarizar, hay una mayor variabilidad en el grupo de Ana que en el grupo de Juan. Para compararlos usamos el valor .
Ambos están a la derecha del promedio, pero Ana está sólo a una desviación estándar del promedio; mientras que Juan está a dos desviaciones estándar del promedio. En comparación a sus grupos, es decir a las situaciones que les correspondió a cada uno, por ejemplo en términos de que tan difícil fue su examen, Juan tiene una mejor valoración que Ana.
🤓 Tabla Gaussiana Estandar
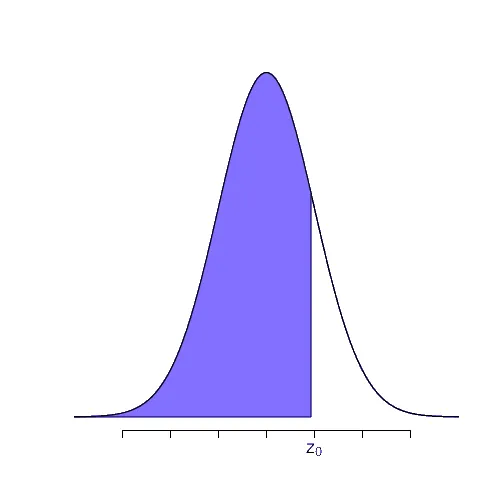
Reporta las probabilidades acumuladas hasta un dado. Es decir, calcula . Es el área de la siguiente gráfica.
Ejemplo
Supongamos que queremos encontrar la probabilidad de que la variable tenga un valor menor a . Eso equivale a encontrar el área bajo la curva desde hasta . Esa área correspondería gráficamente a la siguiente área marcada con violeta:
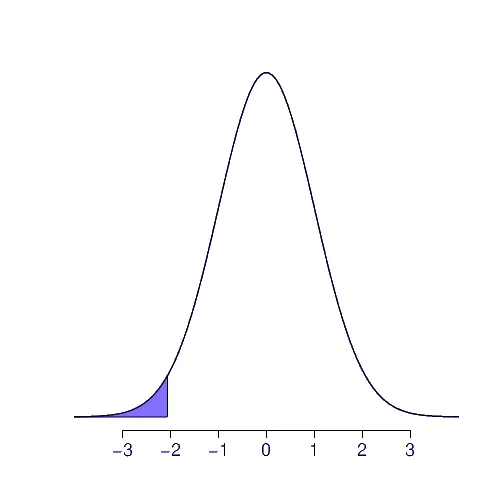
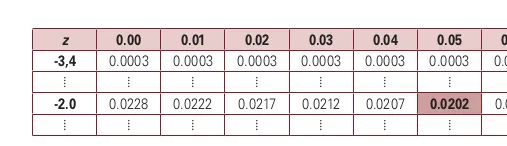
Para encontrar esta probabilidad con el software se usa la tabla. Se buscan las unidades y el primer decimal en la primera columna y el segundo decimal en la primera fila, así:
🤓 Probabilidad a cola derecha
La probabilidad a cola derecha corresponde al área acumulada a partir de un valor. Por ejemplo, la siguiente figura representa la probabilidad :
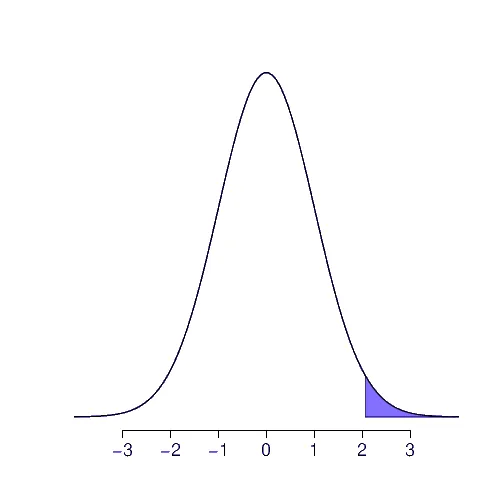
Ahora, en las tablas está la probabilidad a cola izquierda. Luego lo que se hace es buscar el evento complementario , y calcular su probabilidad. El complemento del evento es el evento:
Luego:
🤓 Normal Estándar en Python
Se importa la librería statsde scipy:
import scipy.stats as st
Por ejemplo, para la probabilidad acumulada , se haría:
st.norm.cdf(-2.05)
Lo que da el valor: 0.020182215405704394, se puede aproximar a cuatro decimales en 0.0202.
Para :
1-st.norm.cdf(2)
Se obtiene 0.02275013194817921 o aproximando a cuatro decimales 0.0227.
Recursos:
-
Calculadora en línea DESMOS: https://www.desmos.com/calculator
-
Página de Matt Bognar https://homepage.divms.uiowa.edu/~mbognar/
-
Applet Distribución Normal Matt Bognar https://homepage.divms.uiowa.edu/~mbognar/applets/normal.html
En Khan Academy
Dejaremos como evaluación tres actividades. Luego le tienen que aparecer en su página de Khan Academy en la sección de “tareas”.
-
Cálculos Normales Básicos (leer un artículo)
-
Distribución Normal, área entre dos puntos (calcular)
-
Distribución Normal, área por encima o por debajo de un punto (calcular)
Relación normal - binomial (Máquina de Galton) 🤓
Distribución uniforme continua 🤓
(Contento, pg. 196)
Dada una variable , que puede tomar valores en el intervalo , entonces la densidad uniforme contínua es:
La notación se lee: x se distribuye uniforme contínua en el in tervalo a,b
Valor esperado y varianza de la distribución uniforme continua
Ejemplo (Contento, pg. 188)
La concentración de cierto contaminante está distribuida de manera uniforme en el intervalo a ppm. Si se considera tóxica una concentración de o más, responda las preguntas:
-
¿Con qué probabilidad al tomarse una muestra se encuentra una concentración tóxica? 1.
-
¿Cuál es la concentración media? ¿la varianza?2.
-
¿Con qué probabilidad la concentración es exactamente 10?
Notas a pie